Prism Central を同居させた Nutanix 単一ノードクラスタを公式手順で停止する
TL;DR
ちゃんと公式ドキュメントを見よう。
前回 X11 世代の Supermicro に立てた Nutanix 単一ノードクラスタで、シャットダウンと再起動の手順を公式資料に沿って実測しました。
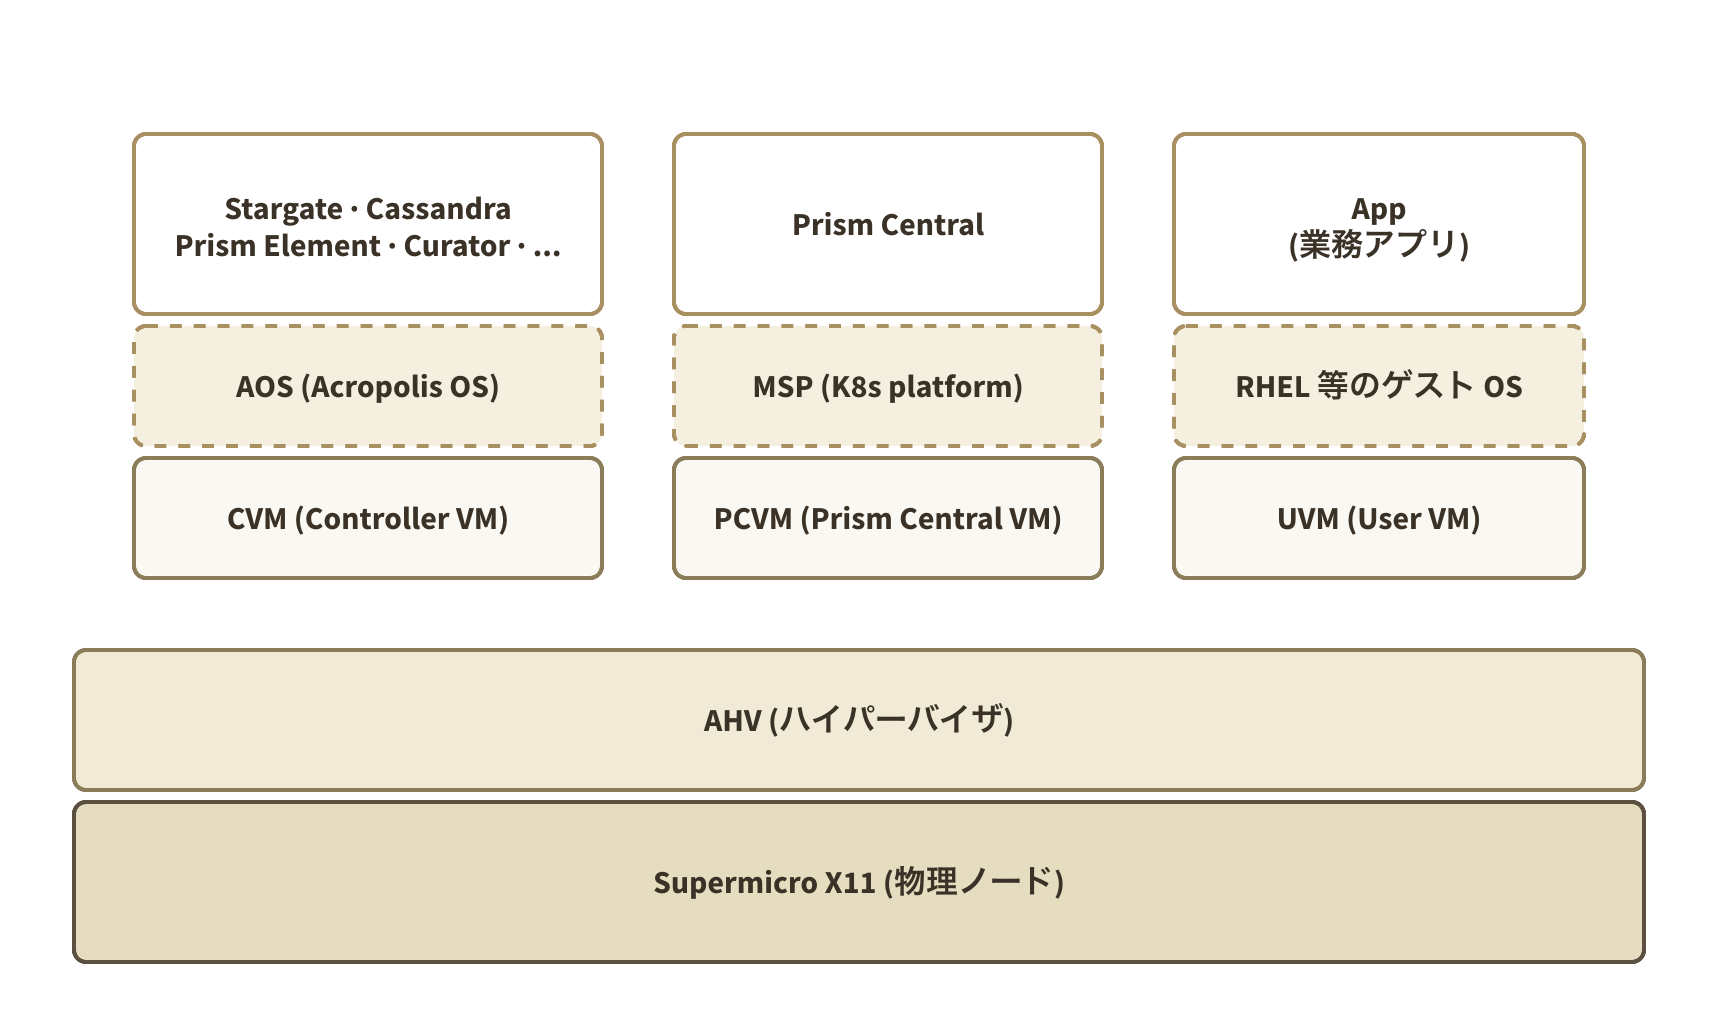
AOS 7.3.1.12 / AHV 10.3.1.10 の 1 台構成で、Prism Central (PC) を同じクラスタ上のゲスト VM として同居させています。
前提
- 物理 1 ノード + AHV + CVM(Prism Element (PE) 等の Nutanix サービスをホスト)
- Prism Central VM (PCVM) は同じクラスタ上のゲスト VM として同居
- RF (Replication Factor) = 1(単一ノードなのでデータの複製先が無く、冗長性なし)
- ユーザ VM (UVM) は無い、または少数
- Nutanix Files (FSVM) と Data Protection ジョブは未使用(使用時は公式手順で別途対応が必要)
Prism Central を「クラスタの管理面」として別クラスタに置く運用もありますが、自宅ラボや検証機では同居構成が多いです。
停止の順序
公式のクラスタ停止手順に沿って、PCVM → 他 UVM → CVM → AHV の順で落とします。
cluster stop の確認プロンプトは I agree を要求します(y / yes は通りません)。
PCVM を先に落とすのは、PCVM が同じ Nutanix クラスタ上のゲスト VM だからです。
CVM で先に cluster stop を叩くと、稼働中の Acropolis VM を検知して Found 1 Acropolis VMs still running on hosts で拒否されます。
このエラーを見過ごし、CVM での sudo shutdown -P now や AHV の停止に進むと、PCVM が稼働したまま Stargate を含むストレージサービスを失い、PCVM の vDisk が I/O error になります。
その状態で AHV まで落とすと PCVM は正常なシャットダウン手続きを踏めず強制電源断となり、内部の MSP (Microservices Platform) の K8s pod 群も正常終了せずに落ちます。
次回起動時の復旧に時間がかかる可能性があります。
# 1. Prism Central VM を graceful shutdown
ssh nutanix@<PCVM IP>
cluster stop
sudo shutdown -P now              # PCVM が VM として off になる

# 2. PE 側で ncc + 稼働 VM 確認 + cluster stop
ssh nutanix@<CVM IP>
ncc health_checks run_all         # 事前チェック(公式手順で必須)
acli vm.list power_state=on       # PCVM off 後は 0 件のはず
cluster stop
cluster status                    # "The state of the cluster: stop" を確認
                                  # Zeus / IkatProxy / Scavenger / VipMonitor は UP で残る想定

# 3. PE CVM を電源断
sudo shutdown -P now              # クラスタ全体停止時は cvm_shutdown ではなくこちら

# 4. AHV host を電源断
ssh root@<AHV IP>
virsh list --all                  # CVM が "shut off" を確認
shutdown -h now                   # AHV host 停止
対話 SSH は login shell で入るので cluster / acli / ncli が PATH で通ります。
非対話で ssh nutanix@<CVM> 'cluster status' のように直接コマンドを渡すと non-login shell になり PATH が通らないので、/usr/local/nutanix/cluster/bin/cluster の絶対パスが要ります。
UVM が残っているとき(今回は PCVM 以外いないので該当なし)は、公式手順に沿って acli vm.shutdown <uuid> で ACPI graceful shutdown を要求し、vm.get の power_state=off を確認してから次に進みます。
応答しない場合のみ acli vm.off <uuid> で強制電源断です。
実測: 停止のコマンドと出力
自宅ラボ(Sougen、AOS 7.3.1.12 / AHV 10.3.1.10 / PC 7.5.1.12、単一ノード)で実際に走らせたときの入出力です。
1. PCVM で cluster stop
$ ssh [email protected]
$ echo I agree | cluster stop
出力の要点:
***** CLUSTER NAME *****
Sougen-PCVM

This operation will stop all Nutanix services, making Prism Central unable
to manage applications and services. Do you want to proceed? (I agree/[N]):
INFO cluster:2492 Cluster has been stopped via 'cluster stop' command
INFO cluster:3785 Success!

Waiting on 192.168.1.15 (Up, ZeusLeader) to stop:
IkatProxy Zeus Scavenger VipMonitor Flow ClusterHealth ClusterManagement
...
The state of the cluster: stop
15 秒で state: stop に遷移しました。
2. PCVM で sudo shutdown -P now
$ sudo shutdown -P now
Shutdown scheduled for ...
SSH セッションが即座に切れ、1 分 37 秒後に PE 側から見た PCVM の state が kOff になりました。
$ ssh [email protected] 'acli vm.get NTNX-...-PCVM-... | grep state'
    power_state_mechanism: "kHard"
  state: "kOff"
3. PE で稼働 VM 確認
PCVM を off にしたので稼働 VM は 0 件です。
$ ssh [email protected]
$ acli vm.list power_state=on
VM name  VM UUID
4. PE で cluster stop
$ echo I agree | cluster stop
出力の末尾:
Waiting on 192.168.1.12 (Up, ZeusLeader) to stop:
IkatProxy Zeus Scavenger VipMonitor
The state of the cluster: stop
Lockdown mode: Disabled
16 秒で完了。
cluster stop は Nutanix サービス群を止めるだけで CVM の OS は生きたままなので、cluster start で戻せます。
Zeus / IkatProxy / Scavenger / VipMonitor が UP のまま残るのは想定挙動です。
5. PE CVM を sudo shutdown -P now
$ sudo shutdown -P now
Connection to 192.168.1.12 closed by remote host.
AHV 側の libvirt で観察すると、CVM ドメインの state が running → shut off に 15 秒で遷移しました。
$ ssh [email protected] 'virsh list --all | grep CVM'
 -    NTNX-3d3f619f-A-CVM   shut off
6. AHV host のシャットダウン
$ ssh [email protected]
$ virsh list --all           # CVM が "shut off" を確認
 Id   Name                  State
--------------------------------------
 -    NTNX-3d3f619f-A-CVM   shut off

$ shutdown -h now
Connection to 192.168.1.13 closed by remote host.
SSH セッションは即座に切れ、ping は 6 秒後に DOWN、BMC の PowerState が Off になるまでさらに 12 秒でした。
7. BMC から電源断を確認
$ curl -K bmc.curlrc -sS https://192.168.1.143/redfish/v1/Systems/1 \
    | jq .PowerState
"Off"
停止タイムライン
| UTC (Sep 25) | イベント | 前ステップ差 |
|---|---|---|
| 11:50:01 | PCVM cluster stop 発行 |
— |
| 11:50:16 | PCVM cluster stop 完了 | +15 秒 |
| 11:50:16 | PCVM sudo shutdown -P now 発行 |
+0 秒 |
| 11:51:53 | PCVM state: kOff 確認 |
+1 分 37 秒 |
| 11:51:53 | PE acli vm.list power_state=on = 0 件 |
— |
| 11:51:53 | PE cluster stop 発行 |
+0 秒 |
| 11:52:09 | PE cluster stop 完了 | +16 秒 |
| 11:52:09 | PE CVM sudo shutdown -P now 発行 |
+0 秒 |
| 11:52:24 | PE CVM libvirt 上で shut off 確認 |
+15 秒 |
| 11:52:24 | AHV shutdown -h now 発行 |
+0 秒 |
| 11:52:30 | AHV ping DOWN | +6 秒 |
| 11:52:42 | BMC PowerState: Off 確認 |
+12 秒 |
PCVM の cluster stop から BMC で PowerState: Off を確認するまで 2 分 41 秒でした。
起動の順序
停止の逆順で、公式のクラスタ起動手順(と 1 ノード起動手順の CVM 起動部)に沿って上げます。
# 1. 物理電源投入(IPMI Redfish の例)
curl -K bmc.curlrc -sS -X POST \
  -H 'Content-Type: application/json' \
  -d '{"ResetType":"On"}' \
  https://<BMC IP>/redfish/v1/Systems/1/Actions/ComputerSystem.Reset

# 2. AHV が上がったら virsh で CVM の起動状況を確認
#    Autostart=disable のまま Nutanix の systemd service 群 (ahv-*-cvm.service) で自動起動する
ssh root@<AHV IP>
virsh list --all | grep CVM

# 3. CVM 起動後、PE 側で cluster start
#    CVM の SSH open 直後は Genesis がまだ、cluster status が応答するまで数分待つ
ssh nutanix@<CVM IP>
cluster status                    # "state: stop" が応答したら次へ
cluster start
cluster status                    # DOWN が 0 件になるまで数分

# 4. PCVM を起動
acli vm.on <PCVM name>

# 5. PCVM SSH open を待ってから、さらに Genesis 起動を待つ
#    SSH open は約 40 秒、Genesis + Zookeeper が上がるまで追加で 6 分ほど
#    SSH ready 直後に cluster start を叩くと Zookeeper 未起動で失敗する
ssh nutanix@<PCVM IP>
cluster status                    # "state: stop" が応答したら次へ

# 6. PCVM 側で cluster start
cluster start
# → 数分で "state: start"、CVM は直接 "Up, ZeusLeader"
#   (sudo shutdown で落とした場合は maintenance mode に嵌らない)

# 7. その他 UVM を順次起動
起動時のハマりどころは 2 箇所です。
- CVM autostart の実体:
virsh dominfoはAutostart: disableを返すが、AHV 起動後に CVM は running になる。libvirt の autostart ではなく、Nutanix の systemd service 群(ahv-generate-cvm-config→ahv-configure-cvm→ahv-install-cvm→ahv-define-cvm)が起動する - PCVM の Genesis ready 待ち: SSH が open した直後の PCVM に
cluster startを打っても、Zookeeper が起動していないので数分待って CRITICAL で失敗する。SSH open からcluster statusが応答するまで実測で約 6 分
停止で sudo shutdown を使えば、起動時の maintenance mode 遷移は発生しません。
実測: 起動のコマンドと出力
同じサイクルで停止した直後に電源再投入した際の記録です。
8. BMC で電源投入
$ curl -K bmc.curlrc -sS -X POST \
    -H 'Content-Type: application/json' \
    -d '{"ResetType":"On"}' \
    https://192.168.1.143/redfish/v1/Systems/1/Actions/ComputerSystem.Reset
{"Success": {"code": "Base.v1_4_0.Success", "Message": "Successfully Completed Request."}}
ResetType: On を叩いてから AHV ping が返るまで 104 秒、AHV SSH open も同じタイミングでした。
9. AHV boot と CVM autostart
$ ssh [email protected] 'journalctl --list-boots | tail -3'
-1 ...  Thu 2026-09-25 11:49 UTC—Thu 2026-09-25 11:52 UTC
 0 ...  Thu 2026-09-25 11:55 UTC—...

$ virsh dominfo NTNX-3d3f619f-A-CVM | grep -E "State|Autostart"
State:          running
Autostart:      disable
Autostart: disable と表示されますが、AHV 起動後に CVM は自動的に running に遷移します。
libvirt の autostart ではなく Nutanix の systemd service 群(ahv-*-cvm.service)が起動します。
10. PE で cluster start
CVM の SSH open 直後は Genesis がまだ起動途中で、cluster status がタイムアウトします。
cluster status が state: stop を返し始めてから cluster start を叩きます(CVM SSH open から実測で 3 分 46 秒後)。
$ ssh [email protected]
$ cluster status | grep "state of the cluster"
The state of the cluster: stop

$ cluster start
出力末尾:
INFO cluster:3785 Success!
    Prism             UP    [...]
    Cerebro           UP    [...]
    ...
The state of the cluster: start
cluster start から cluster status の DOWN が 0 件になるまで 2 分 57 秒でした。
11. PCVM を起動
$ acli vm.on NTNX-192-168-1-15-PCVM-1790135533
NTNX-192-168-1-15-PCVM-1790135533: pending
NTNX-192-168-1-15-PCVM-1790135533: complete
5 秒で pending → complete、その 39 秒後に PCVM の SSH が open しました。
12. PCVM の Genesis ready を待つ
acli vm.on の直後は PCVM の SSH は open ですが Genesis が起動途中で、cluster status を叩いてもタイムアウトで返ってきません。
SSH open から cluster status が state: stop を返し始めるまで、実測で 5 分 57 秒待ちました。
$ ssh [email protected]
$ cluster status | grep "state of the cluster"    # 6 分ほど待つと応答する
The state of the cluster: stop
13. PCVM で cluster start
$ cluster start
INFO cluster:3621 Executing action start on SVMs 192.168.1.15
INFO cluster:3785 Success!
Waiting on 192.168.1.15 (Up, ZeusLeader) to start:

The state of the cluster: start
    CVM: 192.168.1.15 Up, ZeusLeader
sudo shutdown で落としていたので、CVM は Up, ZeusLeader に直接遷移し、Maintenance mode は経由しませんでした。
先に cvm_shutdown -P now で落とした rerun では、ここが CVM: 192.168.1.15 Maintenance から始まり、3 分 9 秒かけて自動 exit するのを観察しました。
原因は cvm_shutdown が Zookeeper に登録する maintenance mode flag で、sudo shutdown を使えば flag は入らず、起動時に maintenance mode を経由しません。
cluster start 発行から MSP pod 群を含む全サービスが UP になるまで約 9 分でした(PC は MSP の起動が重い)。
起動タイムライン
| UTC (Sep 25) | イベント | 前ステップ差 |
|---|---|---|
| 11:53:34 | BMC で ComputerSystem.Reset ResetType:On 発行 |
— |
| 11:55:18 | AHV ping UP / SSH open | +104 秒 |
| 11:56:18 | CVM (PE) SSH open | +60 秒 |
| 12:00:04 | PE CVM で cluster status が応答 |
+3 分 46 秒 |
| 12:00:04 | PE cluster start 発行 |
+0 秒 |
| 12:02:54 | PE cluster start 完了(Success 応答) |
+2 分 50 秒 |
| 12:03:01 | PE 全サービス UP | +7 秒 |
| 12:03:01 | acli vm.on <PCVM> 発行 |
+0 秒 |
| 12:03:06 | acli vm.on complete |
+5 秒 |
| 12:03:45 | PCVM SSH open | +39 秒 |
| 12:09:42 | PCVM で cluster status が応答 |
+5 分 57 秒 |
| 12:09:42 | PCVM cluster start 発行 |
+0 秒 |
| 12:18:48 | PCVM 全サービス UP(Maintenance 経由なし) | +9 分 6 秒 |
BMC 電源投入から PCVM の全サービス UP まで 25 分 14 秒 でした。
シャットダウンの 2 分 41 秒と合わせて、完全なシャットダウン + 再起動サイクルは 27 分 55 秒 です。
教訓: 公式資料を先に読む
この記事は最初、cvm_shutdown -P now を使う手順で書いていました。
Web 検索や外部ブログ(juliendumur.fr、next.nutanix.com のコミュニティ投稿 等)がそう書いていて、実測でも動いていたからです。
しかし Nutanix の日本語 KB PDF 「ホストとクラスターの停止・起動手順」 を読むと、ホスト停止手順(1 ノード外し用)と クラスタ停止手順(クラスタ全体停止)で使うコマンドが明確に分かれていました。
| シナリオ | CVM の落とし方 |
|---|---|
| 1 ノード外し(他ノードで cluster 継続) | acli host.enter_maintenance_mode → cvm_shutdown -P now |
| クラスタ全体停止 | cluster stop → sudo shutdown -P now |
cvm_shutdown は 1 ノード外し用で、VM migration・shutdown token・maintenance mode 遷移が組み込まれています。
cluster stop でクラスタ全体を止めたあとにはこれらの機構は不要(node 数によらず)なので、クラスタ停止手順は sudo shutdown -P now を指定しています。
外部ブログや Web 検索は 1 ノード外しとクラスタ全体停止が混在した状態で流通していて、この記事も先に前者の記述を拾ってしまいました。
cvm_shutdown 版で観測した「起動時に 3 分間 Maintenance mode に嵌り、自動 exit を待つ」現象は、そもそも cvm_shutdown が Zookeeper に maintenance mode flag を入れるからで、公式手順どおりの sudo shutdown なら発生しません。
まとめ
- 停止は PCVM → 他 UVM → CVM で
cluster stop→sudo shutdown -P now→ AHV でshutdown -h now。単一ノード + PC 同居構成で実測 2 分 41 秒 - 起動は逆順で、BMC 電源投入から全サービス UP まで実測 25 分 14 秒。PCVM は SSH が open しても Genesis ready ではないため、そこから 6 分ほど待ちが入る
cvm_shutdown -P nowは 1 ノード外し用。cluster stop後のクラスタ全体停止で使うと、無用な token / traffic forwarding / maintenance mode 遷移が発動して起動時に maintenance mode の自動 exit を待つことになる
参考
- Nutanix サポートドキュメント「ホストとクラスターの停止・起動手順」(PDF、日本語) — 本記事の主な出典。「クラスターの停止・起動手順 - AHV」節が対応
- Shutting Down an AHV Cluster (AHV Admin Guide v10.3)
- Shutting Down a Single-node Cluster
- KB 3270 – How to use the cvm_shutdown script(
cvm_shutdownは 1 ノード外し用途) - Shutting Down or Starting Up Prism Central VM